



Un hack du vendredi à Berlin a mis en évidence un écart entre ce que les développeurs choisissent et ce que l’industrie leur vend
Le vendredi 23 octobre, je suis entré à ma toute première convention de la Global AI Community — un mini-hack «Graphs Gone Wild» à la CODE University de Berlin, organisé par Global AI Berlin avec Microsoft et Neo4j comme sponsors [11][21]. La salle était merveilleuse : âges et parcours divers, rangées d’ordinateurs portables ouverts, des gens construisant de petits prototypes et les montrant à des inconnus. En tant que passionné d’IA et d’informatique, je me suis senti vraiment chez moi.
Ce qui m’a surpris, ce n’était pas la base de données graphe à l’ordre du jour — Neo4j est une réalisation remarquable [21]. C’étaient les ordinateurs portables autour de moi. Presque tout le monde travaillait avec Claude, Copilot ou Gemini. Aucun terminal GLM en vue. Aucun onglet MiMo ouvert.
Je n’arrêtais pas de penser : ce sont des modèles parfaitement intelligents sur ces écrans. Mais ils ne sont pas si loin de l’intelligence des modèles qui coûtent presque cent fois moins [1]. Autre chose déterminait le choix de ces modèles — et ce n’était pas la qualité par token.
L’écart de prix est réel, et il est énorme
Faisons les calculs que le plancher d’une convention fait rarement.
La page tarifaire d’Anthropic indique Claude Opus 5.5 à $4 par million de jetons d’entrée et $20 par million de sortie [1]. Le Gemini 3.1 Pro de Google tourne à $2/$12 [6]. Maintenant l’autre colonne : le GLM-5.3 de Z.ai coûte $1.40/$4.40, et le GLM-5.3-Flash descend à $0.15/$0.50 [5]. Le MiMo-V2.6-Pro de Xiaomi se situe à environ $0.44 en entrée, $0.87 en sortie, avec le niveau Flash à $0.14/$0.28 [7][19]. Les poids eux-mêmes sont sous licence MIT — gratuits à télécharger, gratuits à exécuter, pour toujours [19].
Alors j’ai fait quelque chose de concret. J’ai brûlé 12.2 billion tokens last month and I’m already past 10.5 billion this month [1]. Avec une répartition approximative de 70/30 entrée/sortie, voici ce que ce mois aurait coûté :
| Modèle | Coût mensuel approximatif (utilisateur unique) |
|---|---|
| Claude Opus 5.5 ($4/$20) | ~$108,000 |
| Gemini 3.1 Pro ($2/$12) | ~$61,000 |
| GLM-5.3 ($1.40/$4.40) | ~$28,200 |
| MiMo-V2.6-Pro ($0.44/$0.87) | ~$6,800 |
| GLM-5.3-Flash ($0.15/$0.50) | ~$3,100 |
(Les calculs sont de moi, basés sur les tarifs publiés — votre répartition exacte fera varier les nombres, mais pas la tendance.) Par rapport au palier capable le moins cher, on parle d’une différence de 15 à 35 fois, et par rapport aux tarifs Opus historiques cela approche de la « presque cent fois moins cher » que j’ai avancée en sortant de cette salle [1]. Selon la comptabilité de Xiaomi, le produit phare de MiMo fonctionne à 1/20e à 1/60e du coût des modèles internationaux leaders à intelligence comparable [19]. Artificial Analysis estime MiMo-V2.6-Pro à environ 0,13 $ par tâche de benchmark, tandis que Claude Opus 5 et GPT-6 Astra se situent à 3–8 $ par tâche [13][19].
Pour une équipe de trois avec mon niveau d’utilisation, multipliez ces montants par trois : plus de 324 000 $ par mois sur Opus 5.5, contre environ 9 400 $ sur GLM-5.3-Flash. Ce n’est pas une erreur d’arrondi. C’est une autre économie.
Mais sont-ils réellement aussi bons ? (La réponse honnête : presque)
Ici, je dois être juste envers les ordinateurs portables autour de moi.
La frontière garde l’avantage. Sur l’Artificial Analysis Intelligence Index, Claude Opus 5.5 obtient 58 ; le meilleur modèle open-weight, le MiMo-V2.6-Pro de Xiaomi, obtient 46 [13]. Le suivi de Maxime Labonne sur la frontière ouverte l’énonce clairement : six modèles fermés surpassent encore chaque modèle ouvert, et « les modèles fermés conservent toujours un net avantage sur les tâches de codage agentique en conditions réelles » [16].
Mais l’écart s’est réduit d’un abîme à une marche. Le comparatif côte à côte de VentureBeat de GLM-5.2 a montré qu’il battait GPT-5.5 sur SWE-bench Pro (62,1 vs 58,6), sur l’exécution de tâches à long terme et sur les benchmarks d’utilisation d’outils — pour environ un sixième du coût [8]. Les propres données de Labonne montrent que les modèles open arrivent derrière la frontière fermée de seulement 6–8 points d’indice [16]. Sur des cas précis, comme je l’ai dit dans ce hall, les modèles bon marché peuvent dépasser Opus. En moyenne, ils ne l’embarrassent plus.
GLM-5.3 mérite son propre paragraphe
GLM-5.3 est le modèle que je n’ai vu sur aucun ordinateur portable à Berlin, et c’est celui vers lequel convergent les données. Sur l’Artificial Analysis Intelligence Index, il obtient 45 — troisième sur 121 modèles [13]. Son Coding Index est de 74,8 et son Agentic Index est de 53,1 [7] — tous deux clairement dans la plage que l’on attend d’un outil de pointe, à $1.40/$4.40 au lieu de $4/$20. Sur GPQA Diamond il atteint 91,7 % [7]. Les propres chiffres de Z.ai, reproduits par VentureBeat, montraient que GLM-5.2 — le prédécesseur — battait GPT-5.5 sur SWE-bench Pro ; GLM-5.3 a hérité de cette lignée et a poussé plus loin [8].
Deux mises en garde honnêtes : Artificial Analysis signale GLM-5.3 comme « particulièrement coûteux » pour un modèle à poids ouverts* et « très verbeux » (210M de tokens de sortie contre une médiane à 140M) [13] — la verbosité grignote les économies par token. Et Z.ai a depuis ajouté GLM-5.3-Prime, une couche de service à haute vitesse exécutant les mêmes poids* à exactement le double du prix ($2.80/$8.80) [7]. L’ironie est manifeste : même le modèle bon marché a désormais une voie rapide premium.
L’argument des outils compte aussi
GLM prend en charge nativement l’Anthropic Messages API, ce qui signifie qu’il s’intègre directement dans des environnements de type Claude Code — les mêmes workflows d’agent — sans cage propriétaire [8]. Ce que l’on appelle souvent « outils restrictifs » dans les produits de pointe n’est pas une nécessité technique. C’est un modèle économique.
La comparaison complète selon cinq angles
L’achat intelligent ne se résume pas à un seul chiffre. Voici la vue multi-axes :
| Angle | GLM-5.3 / MiMo | Claude Opus 5.5 / GPT-class |
|---|---|---|
| Coût mensuel @ 12.2B jetons | ~$28,200 / ~$6,800 | ~$108,000 |
| Indice de codage | 74.8 (GLM-5.3) [7] | Le codage AA n’est pas isolé, mais Opus domine l’intelligence 58→45 [13] |
| Agentivité / utilisation d’outils | 53.1 (GLM-5.3); MCP-Atlas 77.0 vs 75.3 de GPT-5.5 (GLM-5.2) [7][8] | Opus 5.5 domine l’indice global [13] |
| Fenêtre de contexte (entrée) | 1,048,576 (~1M) [7] | 1M (fenêtre complète au prix standard) [1] |
| Nombre maximal de jetons de sortie | 131,072 (128K) [7] | limite côté serveur, non publiée |
| Lecture du cache | GLM-5.3 $0.26; MiMo-Pro $0.0036 (99 % de réduction) [5][7][19] | Opus 5.5 $0.20 (5 % de l’entrée) [1] |
Deux choses sautent aux yeux. Premièrement, la remise sur le cache de MiMo est absurde — $0.0036 par million de jetons mis en cache [19] — et le codage par agents relit constamment le même dépôt, si bien que le prix d’entrée *effectif* pour les charges de travail des agents n’est qu’une fraction même du tarif de liste le moins cher. Deuxièmement, GLM et MiMo égalent le contexte de pointe (1M+) au palier bon marché, tandis que Gemini facture davantage au-delà de 200K jetons [6] — un coût caché qui favorise le fournisseur le plus cher.
Pourquoi tout le monde loue-t-il les services coûteux ?
Si l’économie est si déséquilibrée, la salle de conférence aurait dû être différente. Quatre forces expliquent cet écart.
Les forfaits ne peuvent pas transporter vos jetons — par conception
Tous les principaux outils «claw» — Claude Code, Codex, GitHub Copilot — sont vendus sous forme d’abonnement, pas de jetons bruts. Claude Code est fourni avec Claude Pro (17–20 $/mois) ou Max (100–200 $/mois), mais l’utilisation est mesurée sur une fenêtre de session roulante de cinq heures plus des plafonds hebdomadaires [1]. Codex est inclus dans les plans ChatGPT (Plus ~20 $, Pro 100–200 $) avec 10–60 tâches cloud par fenêtre de cinq heures au niveau d’entrée [20]. GitHub Copilot facture un siège (10–100 $/mois) plus des crédits GitHub AI à 0,01 $ chacun pour le travail d’agent [24].
Appliquez maintenant mon utilisation à ces plafonds. 12,2 milliards de jetons par mois correspondent à peu près à 400 millions de jetons par jour [1]. Aucun forfait fixe au monde n’exprime cela. Si vous dépassez la fenêtre, vous êtes soit bridé, soit facturé au jeton aux tarifs API — 4 $/20 $ sur Opus 5.5 [1] — ce qui signifie que la sensation « illimitée » d’un abonnement à 20 $ s’évapore dès que vous travaillez comme moi.
Regardez ce qui arrive au coût effectif par jeton lorsque le plafond fait son travail. Un seul siège Max-20x Claude coûte 200 $/mois [1]. Voici maintenant la partie que les vendeurs n’impriment pas sur la page tarifaire : personne ne publie quel est réellement le plafond. Anthropic le décrit comme une « fenêtre de session glissante de cinq heures plus des limites hebdomadaires » [1] — mais aucun nombre de jetons n’apparaît nulle part. Le plafond est un secret d’entreprise, réinitialisé selon un calendrier que vous ne pouvez pas auditer, ajusté à la discrétion du fournisseur. Pour rendre les calculs concrets, supposons — et cette hypothèse vous est délibérément exposée, lecteur, précisément parce qu’Anthropic ne nous communiquera pas de chiffre réel* — un généreux 500 millions de jetons par cycle de forfait. Avec cette allocation supposée, votre tarif effectif dans la fenêtre est de 0,40 $ par million de jetons. Si vous franchissez le seuil non publié, les jetons marginaux du même siège sont facturés à 4 $ en entrée / 20 $ en sortie — une augmentation de cinquante fois, du jour au lendemain, en raison d’une limite dont on ne vous a jamais informé. Mon propre usage, 400 millions de jetons par jour* [1], épuiserait ce forfait supposé en trente-six jours — non, en trente-six heures ; les vingt-neuf jours restants du mois seraient facturés aux tarifs API pleins, faisant grimper le coût effectif du siège de 200 $ vers le chiffre de 108 000 $ par utilisateur dans le tableau ci‑dessus.
C’est le piège inscrit dans le mot « inclus ». Le plafond n’est pas une limite de vos dépenses — c’est une limite sur votre remise, protégée par un chiffre opaque que seul le fournisseur connaît. Vous n’achetez pas un outil ; vous louez l’autorisation, à un prix qui varie au gré de quelqu’un d’autre. Franchissez la ligne, et l’abonnement n’a en réalité jamais été un abonnement. C’était un forfait à paiement à l’usage déguisé en un montant mensuel rassurant.
Ces plafonds ne sont pas une limite technique. Ce sont le prix d’entrée vers les tarifs réels — et la facture est illisible jusqu’à ce qu’elle arrive. Ce sont des dépenses lourdes déguisées en commodité, et l’opacité est le but : un client qui ne peut pas voir le plafond ne peut pas comparer le plafond.
Publicité, à l’échelle industrielle
CNBC a rapporté que Microsoft et Google ont payé à des créateurs individuels $400,000–$600,000 pour des accords de promotion sur plusieurs mois, tandis que les plateformes d’IA générative ont dépensé plus de 1 milliard de dollars en publicités numériques aux États-Unis en 2025 — en hausse de 126 % d’une année sur l’autre [4]. Anthropic est décrit comme « l’un des plus agressifs » en matière de marketing auprès des créateurs [4] ; une analyse a compté 31 créateurs sponsorisés publiant 50 posts #ClaudePartner, principalement des influenceurs de niveau intermédiaire [9]. Et maintenant, les produits eux-mêmes diffusent des publicités : OpenAI a commencé à tester des annonces dans ChatGPT début 2026, ciblées selon le sujet de vos conversations [12]. À la décharge d’Anthropic, la société s’est publiquement engagée à ce que Claude reste sans publicité [14] — mais les paiements aux influenceurs sont encaissés dans les deux cas. Business Insider a documenté que des créateurs faisaient face à des réactions négatives de leur audience, certains exigeant une prime de risque de 20–30 % pour publier des parrainages liés à l’IA [23].
Paramètres par défaut déguisés en recommandations
OpenAI a annoncé que GPT-5.6 deviendrait le « modèle préféré » pour Microsoft 365 Copilot [20]. CNBC a obtenu une note interne de Microsoft demandant aux développeurs d’utiliser par défaut le produit phare d’OpenAI : * »déplacer davantage de charges de travail vers les modèles d’OpenAI nous aide à tirer plus de valeur de notre investissement en jetons »* [15]. Ce n’est pas un développeur qui choisit le meilleur outil. C’est un partenariat qui choisit pour eux.
Des classements qui peuvent être truqués
L’étude The Leaderboard Illusion a révélé que Meta a testé 27 variantes privées de Llama-4 avant de publier uniquement celle qui obtenait le meilleur score, et a estimé que Google et OpenAI avaient reçu 19,2 % et 20,4 % de toutes les données de Chatbot Arena tandis que 83 modèles à poids ouverts se partageaient 29,7 % [3][18]. Lorsqu’un classement est faussé, la salle suit le classement.
Les boîtes sont le piège
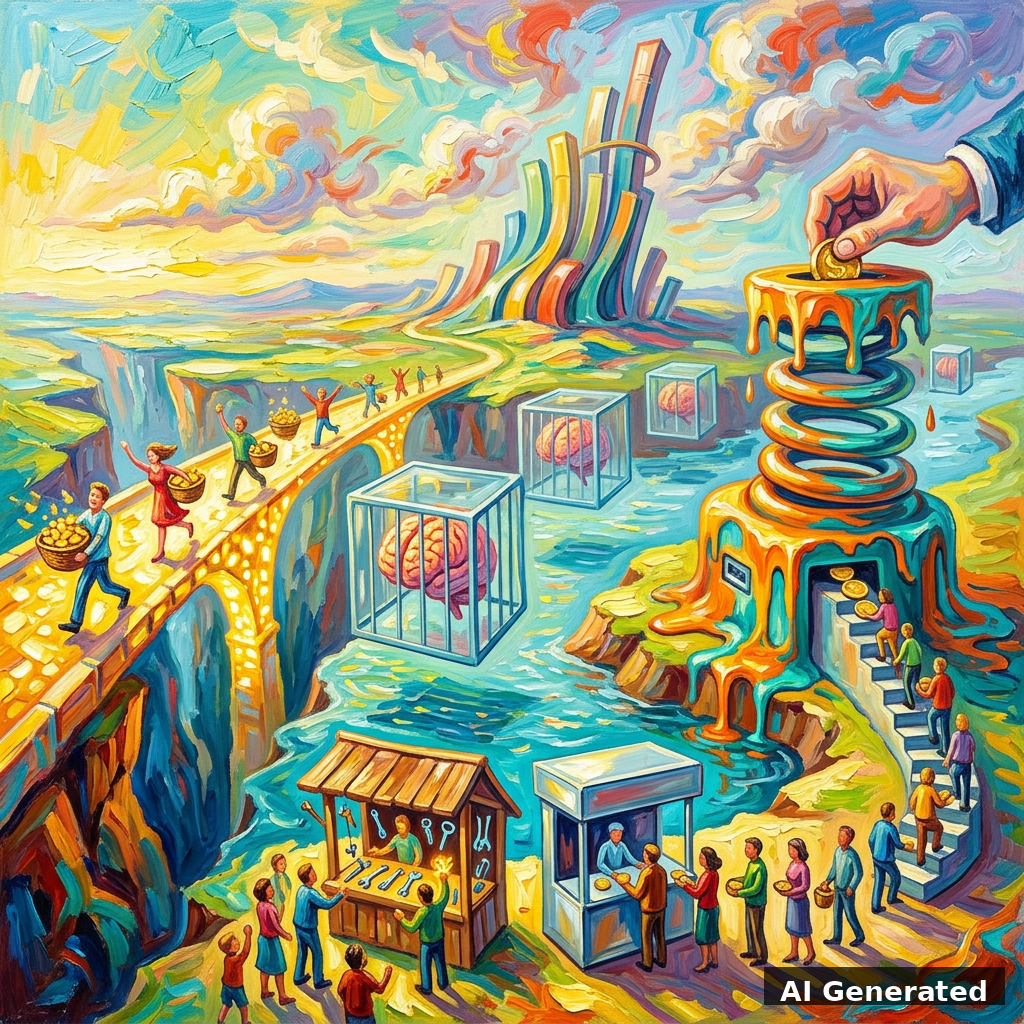
À la convention, j’entendais sans cesse de merveilleuses idées — gestion des tâches, workflows automatisés — toutes assemblées à l’intérieur de boîtes hébergées : un serveur que vous louez, une base de données que vous ne possédez pas, une « griffe » à laquelle vous vous abonnez [1]. J’ai vu ces jardins clos tôt dans mon propre parcours en IA, sur ChatGPT et Perplexity, et ma réaction alors est la même qu’aujourd’hui : encombrante, surchargée et boguée — probablement parce que l’idée est que vous *ne pouvez pas* l’héberger vous-même sur un serveur bon marché [1].
Les données indiquent que c’est intentionnel, pas accidentel. Une enquête de Zapier auprès de 542 cadres a révélé que 81% craignaient la dépendance vis‑à‑vis des fournisseurs d’IA, 47% perdraient une fonction métier clé si leur fournisseur faisait défaut, et seulement 6% pourraient changer sans perturbation [17]. Le verrouillage se forme désormais au niveau des flux de travail en environ 18 mois — moins de la moitié du temps qu’a pris le verrouillage cloud [17]. La marchandise, c’est le modèle. La plateforme est le piège.
Et la sortie est ouverte. L’équilibre de rentabilité de l’auto‑hébergement par rapport aux tarifs d’API premium se situe autour de 5–10 millions de tokens par jour [22]. Je consomme environ 400 millions par jour. Pour les gros utilisateurs, l’argument financier en faveur de la possession de sa pile n’est pas discutable.
Et vous n’avez même pas besoin du meilleur modèle bon marché
Voici le point que l’industrie ne veut pas que vous remarquiez : GLM-5.3 et MiMo représentent le bout capable* du spectre bon marché. En dessous se trouve tout un palier — les variantes Flash de DeepSeek, MiniMax, Qwen, les plus petits modèles GLM-Flash et MiMo-Flash — fonctionnant à $0.10–$0.50 par million de tokens [2][5]. Pour la rédaction, le résumé, la classification, les contenus standard, les premières passes sur des tâches bien cadrées, ces modèles sont amplement suffisants. La seule raison de faire transiter tout* par un modèle phare à 20 $ de sortie est l’habitude, le marketing, ou un choix par défaut que quelqu’un d’autre a fait pour vous.
Ces boîtes restreignent, compressent et oppriment les talents et les opportunités [1] — non pas parce que les modèles à l’intérieur sont faibles, mais parce que les murs qui les entourent décident qui peut construire, à quel prix, et sur quelle infrastructure.
Le classement que personne ne peut acheter
C’est ici que l’histoire devient porteuse d’espoir — et tout cela revient à ces ordinateurs portables.
Regardez les classements en direct d’OpenRouter, mesurés en tokens réellement traités par des millions de développeurs [2]. Les modèles en tête du mois : DeepSeek V4.1 Flash, GLM 5.3 Flash, MiMo-V2.6-Flash, Hy4 de Tencent, une autre variante de DeepSeek. Dans la vue hebdomadaire, les cinq premiers sont DeepSeek, DeepSeek, MiniMax, GLM — et Tencent. Claude Opus 5.5 se classe sixième [2]. Par éditeur : DeepSeek 24,4 % des requêtes, puis Google, OpenAI, Z.ai — Anthropic en queue de peloton à 4,7 % [2].
Personne n’a sponsorisé ces positions. Les développeurs ont voté avec leurs tokens — pour le coût, pour les capacités, pour la liberté de changer. Andrej Karpathy lui-même a proposé ces classements d’utilisation comme une alternative plus difficile à manipuler par rapport à Chatbot Arena, parce que chaque requête routée « vote directement pour une combinaison capacité+coût » [10].
Un avertissement honnête : le volume de tokens montre ce qui est utilisé, pas ce qui est meilleur, et certaines variantes du niveau gratuit gonflent certains chiffres [2]. Mais la tendance est indubitable. Qwen, comme je l’ai noté, est présent mais plus faible — environ 5,3 % des requêtes [2]. Le marché a déjà parlé ; il parle juste une langue que les sponsors ne reprennent pas.
Ce que Global AI devrait développer
Je suis reparti de la convention avec rien d’autre que de la chaleur pour les personnes dans cette salle. Mais mon attente — et mon message aux organisateurs — est ceci : L’IA globale devrait faire croître l’IA en faisant croître la personne, pas le produit [1].
La pile qui permet à un étudiant dans cette salle de construire un système de tâches souverain à 100 % existe déjà, est sous licence MIT et coûte presque rien [5][7][19]. La convention a même dit « utilisez la pile que vous voulez… ou quelque chose de complètement expérimental » [11]. Alors que l’enseignement soit à la hauteur de l’invitation : faites tourner des modèles peu coûteux, possédez la base de données, connectez-la vous-même sur du matériel que vous contrôlez.
Par nature, je fais à ma façon, avec mes propres outils — connaissances, capacités, compétences, expériences que personne ne peut me reprendre sous licence [1]. Ce n’est pas une excentricité. En 2026, avec des outils déjà gratuits, cela devrait être la norme.
Libérez-les du souci financier, et les gens s’ouvrent et créent [1]. Les modèles sont prêts. Les salles sont pleines. La seule chose encore à louer est l’autorisation.
—
Références
[1] Anthropic. (2026). Plans et tarifs. Claude par Anthropic. https://claude.com/pricing — combiné avec des chiffres d’utilisation personnels et des observations tirées de l’enregistrement vocal de l’auteur (noteshelf_recording.m4a ; 12,2 milliards de tokens/mois, observation des « boxes », argument de souveraineté).
[2] OpenRouter. (2026). Classements des LLM — classements en direct basés sur l’utilisation réelle (données jusqu’au 24 oct. 2026). OpenRouter, Inc. https://openrouter.ai/rankings
[3] Singh, S., Nan, Y., Wang, A., D’Souza, D., Kapoor, S., Üstün, A., Koyejo, S., Deng, Y., Longpre, S., Smith, N. A., Ermis, B., Fadaee, M., & Hooker, S. (2025). L’illusion du classement. prépublication arXiv:2504.20879. https://doi.org/10.48550/arXiv.2504.20879
[4] Vallese, Z. (6 février 2026). Google et Microsoft proposent des accords lucratifs pour promouvoir l’IA, mais même 500 000 $ ne convaincront pas certains créateurs. CNBC. https://www.cnbc.com/2026/02/06/google-microsoft-pay-creators-500000-and-more-to-promote-ai.html
[5] Z.AI. (2026). Tarification — Aperçu. Documentation développeur Z.AI. https://docs.z.ai/guides/overview/pricing
[6] Google. (2026). Tarification de l’API Gemini pour développeurs. Google AI for Developers. https://ai.google.dev/gemini-api/docs/pricing
[7] OpenRouter. (2026). MiMo-V2.6-Pro & GLM 5.3 — Tarification de l’API et benchmarks. https://openrouter.ai/xiaomi/mimo-v2.6-pro · https://openrouter.ai/z-ai/glm-5.3
[8] Franzen, C. (16 juin 2026). Le GLM-5.2 à poids ouverts de Z.ai bat GPT-5.5 sur plusieurs benchmarks de codage à long terme pour 1/6e du coût. VentureBeat. https://venturebeat.com/technology/z-ais-open-weights-glm-5-2-beats-gpt-5-5-on-multiple-long-horizon-coding-benchmarks-for-1-6th-the-cost
[9] Mahoney, M. (30 juin 2025). Étude de cas de marketing d’influence B2B : à l’intérieur du programme de marketing d’influence d’Anthropic. Favikon. https://www.favikon.com/blog/inside-anthropic-influencer-marketing-program
[10] Willison, S. (30 avril 2025). Comprendre les récentes critiques de la Chatbot Arena. Simon Willison’s Weblog. https://simonwillison.net/2025/Apr/30/criticism-of-the-chatbot-arena/
[11] Global AI Community. (2026). Graphes en folie. https://globalai.community/e/ack9t53d
[12] Perez, S. (9 février 2026). ChatGPT déploie des publicités. TechCrunch. https://techcrunch.com/2026/02/09/chatgpt-rolls-out-ads/
[13] Artificial Analysis. (2026). Comparaison des modèles d’IA en termes d’intelligence, de performance et de prix. https://artificialanalysis.ai/models
[14] Anthropic. (4 février 2026). Claude est un espace pour réfléchir. Anthropic. https://www.anthropic.com/news/claude-is-a-space-to-think
[15] Novet, J. (5 août 2026). Un responsable de Microsoft AI demande aux développeurs de définir par défaut le meilleur modèle d’OpenAI dans le cadre d’une initiative visant l’efficacité. CNBC. https://www.cnbc.com/2026/08/05/microsoft-makes-openai-gpt-5point6-sol-default-in-github-copilot-for-staff.html
[16] Labonne, M. (6 juillet 2026). L’état de la frontière ouverte. Substack de Maxime Labonne. https://maximelabonne.substack.com/p/the-state-of-the-open-frontier
[17] Gazivoda, D. (9 avril 2026). Le piège de l’infrastructure IA : comment les trois principaux acteurs verrouillent discrètement votre organisation d’ingénierie. StepTo. https://stepto.net/blog/ai-vendor-lock-in-infrastructure-risk-2026
[18] Whitwam, R. (1 mai 2025). Une nouvelle étude accuse LM Arena de manipuler son populaire benchmark d’IA. Ars Technica. https://arstechnica.com/ai/2025/05/researchers-claim-lm-arenas-ai-leaderboard-is-biased-against-open-models/
[19] eesel AI. (23 septembre 2026). Tarification du Xiaomi MiMo V2.6 : tous les forfaits, modèles et coûts d’API en 2026. eesel AI. https://www.eesel.ai/blog/xiaomi-mimo-v2-6-pricing
[20] OpenAI. (2026). Codex — Partenaire de codage IA. OpenAI. https://openai.com/codex/ · Annonce du modèle préféré GPT-5.6 : https://openai.com/index/gpt-5-6-preferred-model-microsoft-365-copilot/
[21] Zaid, Z. [Global AI Berlin]. (23 octobre 2026). Graphs Gone Wild — Mini Hack. Meetup / Global AI Berlin. https://www.meetup.com/de-DE/de-DE/global-ai-berlin/events/316500152/
[22] Lehmkämpfer, C. (1er juin 2026). Comparaison des coûts des LLM open source vs API fermées en 2026. Lyceum Technology. https://lyceum.technology/magazine/open-source-vs-closed-api-llm-cost-comparison/
[23] Bradley, S., & Whateley, D. (20 août 2026). Le débat le plus chaud de l’économie des créateurs : les influenceurs peuvent-ils publier des publicités générées par l’IA sans aliéner leurs fans ? Business Insider. https://www.businessinsider.com/ai-brand-deals-chatgpt-claude-influencers-weigh-backlash-over-paychecks-2026-8
[24] GitHub. (2026). GitHub Copilot — Forfaits et tarifs. https://github.com/features/copilot/plans
Divulgation IA — Cet article a été recherché, rédigé et édité avec l’assistance d’outils d’IA. Toutes les images et la vidéo mise en avant dans cet article ont été générées par l’IA et sont étiquetées «Généré par l’IA» conformément à la loi européenne sur l’IA.
